Dostawa sprzętu

Serwery GPU dobrane pod Twoje obciążenie.

TRcompute dobiera serwery GPU i koordynuje dostawę zgodnie z uzgodnioną specyfikacją. Wyślij listę materiałową lub zacznij od modeli, które uruchamiasz, potrzebnych mocy i miejsca instalacji.

Od wymagań do listy sprzętu

Pomagamy przekształcić Twój brief w konfigurację do wyceny: akceleratory, platformę serwerową, CPU, pamięć, storage i interfejsy sieciowe. Jeśli masz już numery katalogowe, możemy pracować na ich podstawie i omówić alternatywy, jeśli to konieczne.

Wycena określa proponowany sprzęt, ilości, warunki handlowe i założenia dostawy. Instalacja, konfiguracja oprogramowania i bieżące wsparcie są ustalane osobno, gdy jest to potrzebne.

Sprzęt

Stacje robocze AI, GPU i pamięci, które dostarczamy.

To przykłady z szerszego katalogu. Dostępnych jest wiele innych akceleratorów, platform, stacji roboczych i komponentów. Dokładne modele, ilości i terminy realizacji potwierdzane są w wycenie.

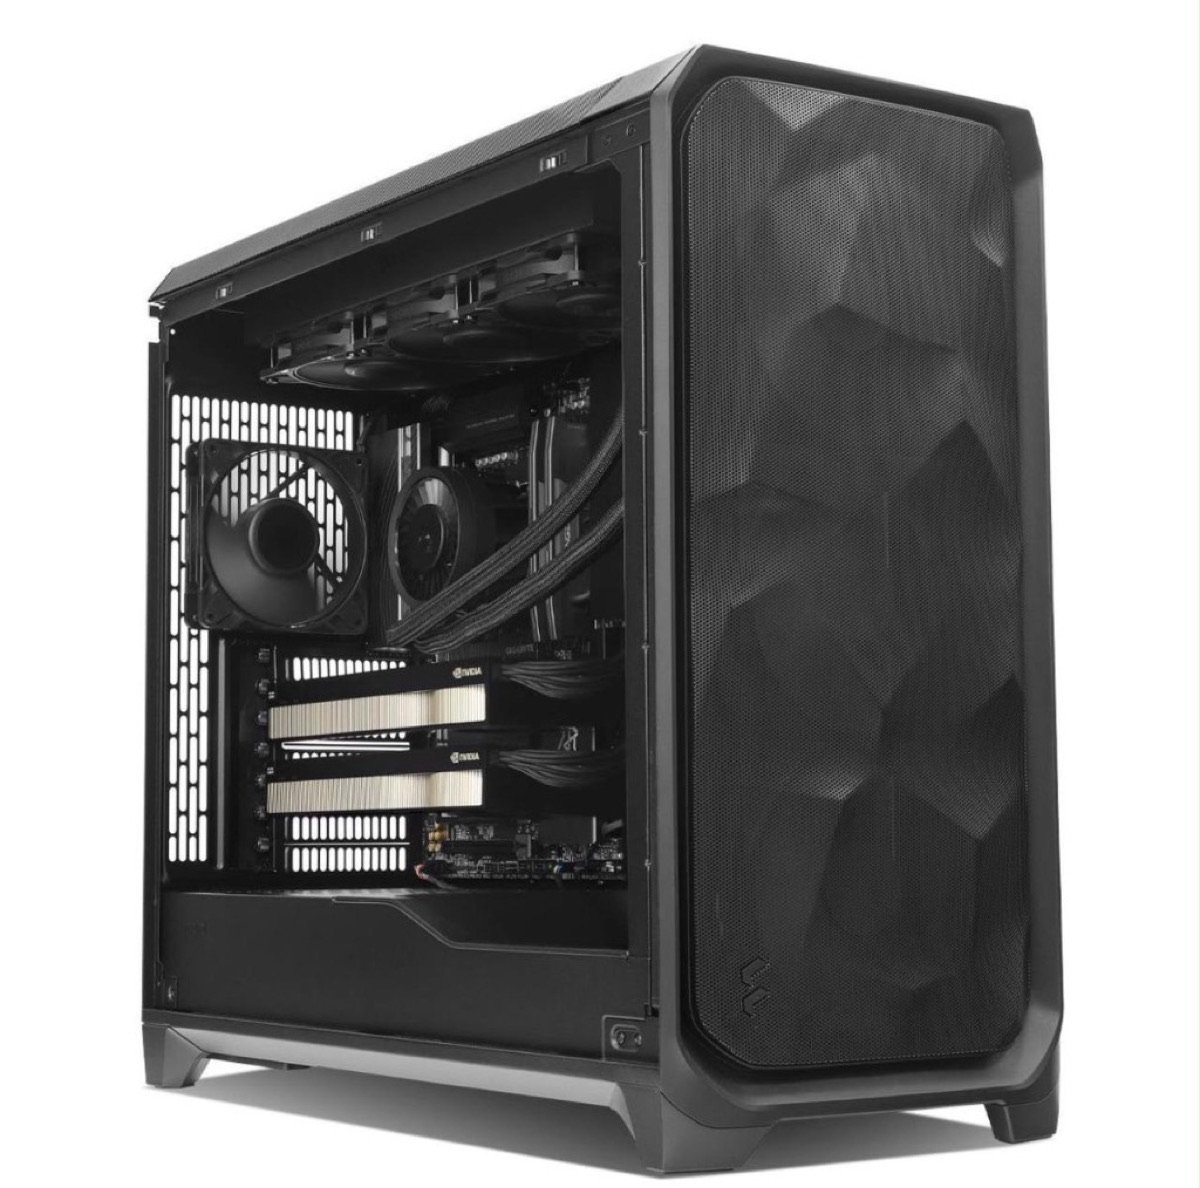
Niestandardowa stacja robocza AI z dwoma GPU NVIDIA

Custom build

AI Workstations

Twoja AI. Twoja infrastruktura. Twoja kontrola.

Wydajne stacje robocze AI, budowane na zamówienie dla firm, profesjonalistów i klientów indywidualnych. Specjalizowany komputer zaprojektowany do uruchamiania modeli AI, przetwarzania dużych zbiorów danych i obsługi wymagających obciążeń obliczeniowych — lokalnie, pod Twoją kontrolą.

Każdy system jest indywidualnie projektowany i budowany. Konfigurujemy GPU NVIDIA, procesory, RAM i storage SSD, aby zrównoważyć wydajność, niezawodność i koszty względem Twoich wymagań.

  • Firmy Rozwiązania AI, automatyzacja procesów i analiza danych
  • Deweloperzy AI Lokalne uruchamianie, testowanie i trenowanie modeli
  • Zespoły kreatywne Generowanie obrazów i wideo AI, rendering 3D i tworzenie treści
  • Nauka i inżynieria Obliczenia naukowe, symulacje i złożone kalkulacje
  • Klienci indywidualni Osobiste projekty AI i prywatne, lokalnie hostowane systemy
Budowa
Konfiguracja indywidualna na podstawie Twojego briefu
GPU
Akceleratory NVIDIA dobrane do Twoich obciążeń
Platforma
CPU, RAM i SSD zbalansowane pod kątem wydajności i kosztów
Zastosowanie
Lokalna inferencja AI, trening, obciążenia kreatywne i badawcze
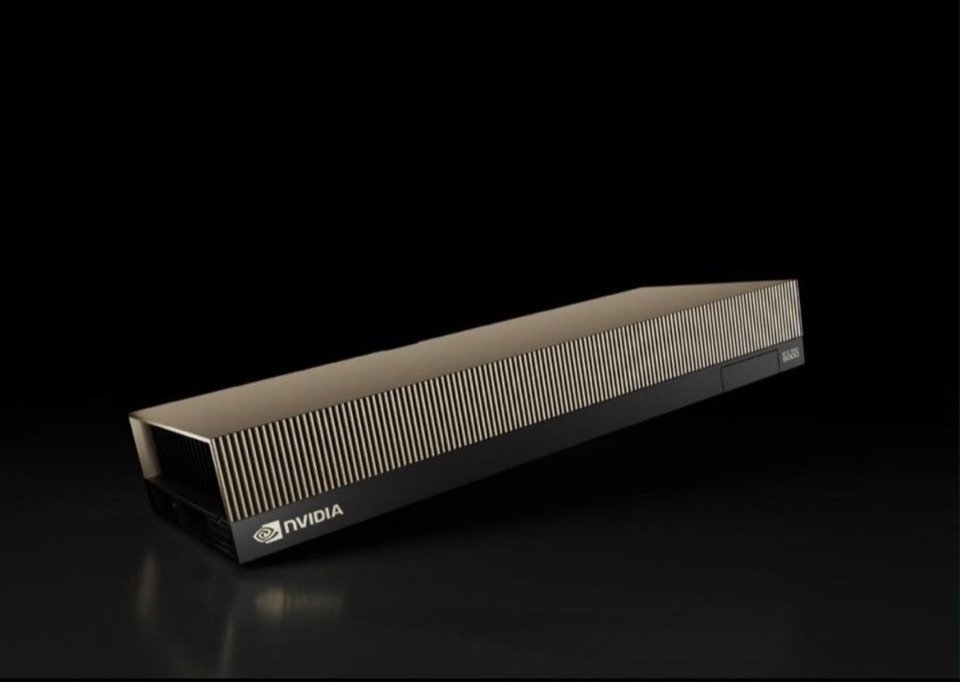
Karta GPU NVIDIA RTX PRO 6000 Blackwell Server Edition

RTX PRO 6000 Blackwell Server Edition

96 GB GDDR7

Profesjonalny GPU Blackwell do inferencji AI, wizualizacji i obciążeń enterprise w środowiskach serwerowych.

Architektura
NVIDIA Blackwell
Pamięć GPU
96 GB GDDR7 z ECC
Magistrala pamięci
512-bit · do 1 597 GB/s
Rdzenie CUDA
24 064
Tensor / RT
752 Tensor (5. gen.) · 188 RT (4. gen.)
FP32 / FP4
120 TFLOPS · do 4 PFLOPS AI
Interfejs
PCIe 5.0 ×16
Format
Dual-slot FHFL · chłodzenie pasywne
Zasilanie
Do 600 W (konfigurowalne)
MIG
Do 4 instancji @ 24 GB
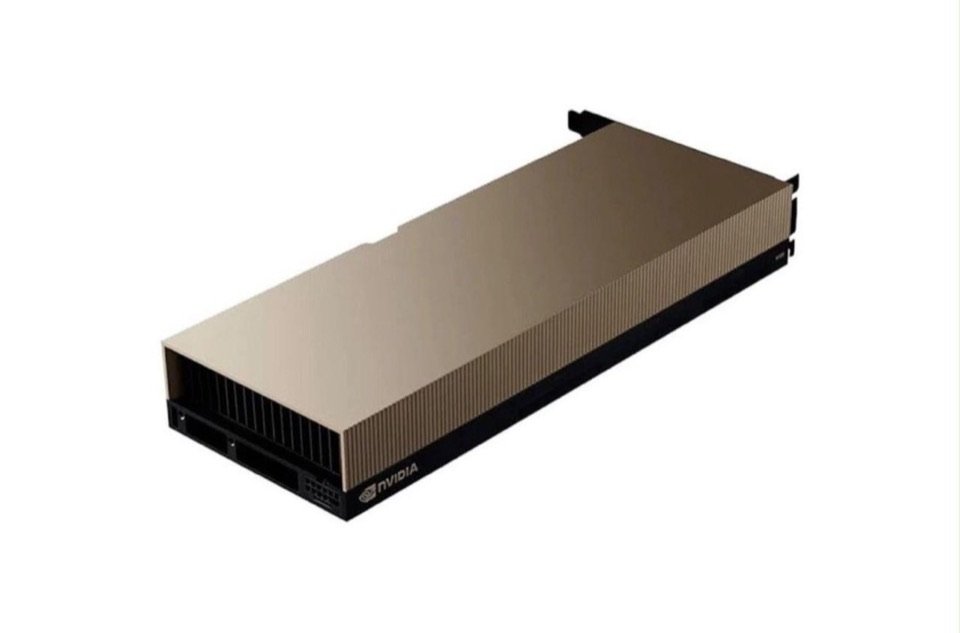
GPU NVIDIA H200 NVL 141 GB do centrów danych

H200 NVL

141 GB HBM3e

GPU do centrów danych do inferencji i treningu dużych modeli, gdzie kluczowa jest duża pojemność pamięci.

Architektura
NVIDIA Hopper
Pamięć GPU
141 GB HBM3e
Przepustowość
Do 4,8 TB/s
FP8 Tensor
Do 3 341 TFLOPS
FP16 / BF16
Do 1 671 TFLOPS
FP64
30 TFLOPS · 60 TFLOPS Tensor
Interfejs
PCIe Gen5 · NVLink bridge 2- lub 4-way
NVLink
900 GB/s na GPU
Format
Dual-slot PCIe · chłodzenie powietrzne
Zasilanie
Do 600 W (konfigurowalne)
MIG
Do 7 instancji @ 16,5 GB
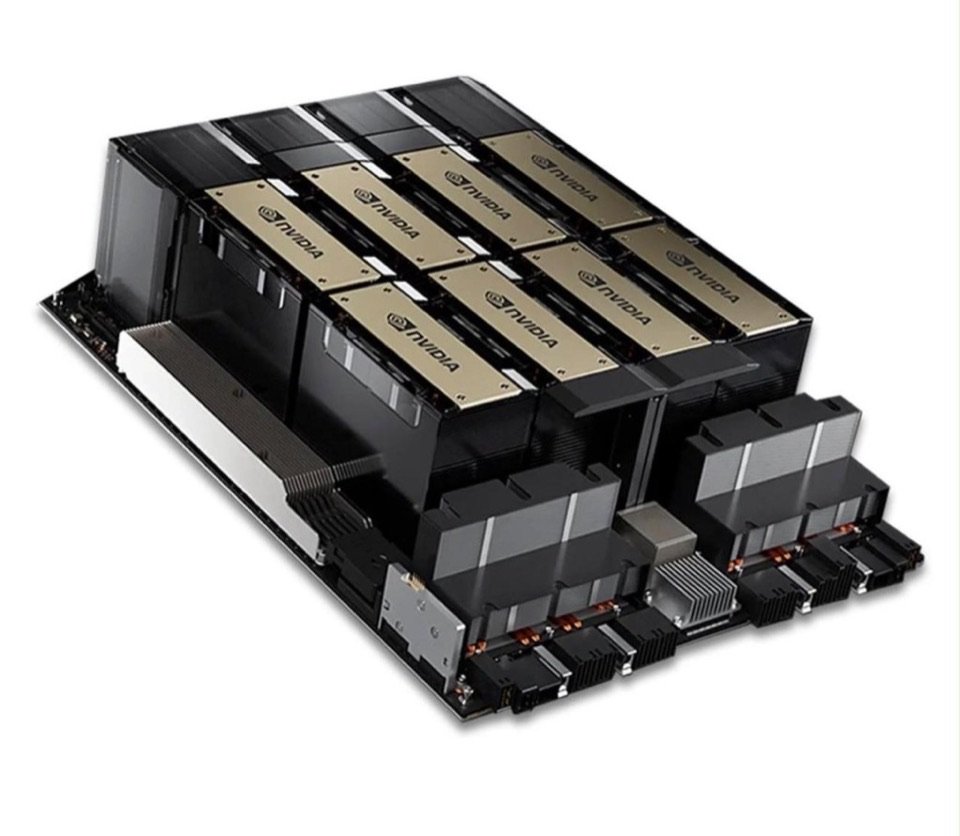
Płyta bazowa NVIDIA HGX B200 z ośmioma GPU

NVIDIA HGX B200

8× Blackwell SXM

Gęsta platforma obliczeniowa Blackwell do treningu AI na dużą skalę i systemów multi-GPU.

Konfiguracja
8× NVIDIA Blackwell B200 SXM
Pamięć / GPU
180 GB HBM3e
Pamięć łączna
Do 1,44 TB HBM3e
Przepustowość GPU
Do 8 TB/s na GPU
FP4 / FP8
Do 72 / 72 PFLOPS (dense)
FP16 / BF16
Do 36 PFLOPS
NVLink
5. gen. · 1,8 TB/s GPU-to-GPU
NVSwitch
14,4 TB/s łączna przepustowość NVLink
Zasilanie
Konfigurowalne do 1 000 W na GPU
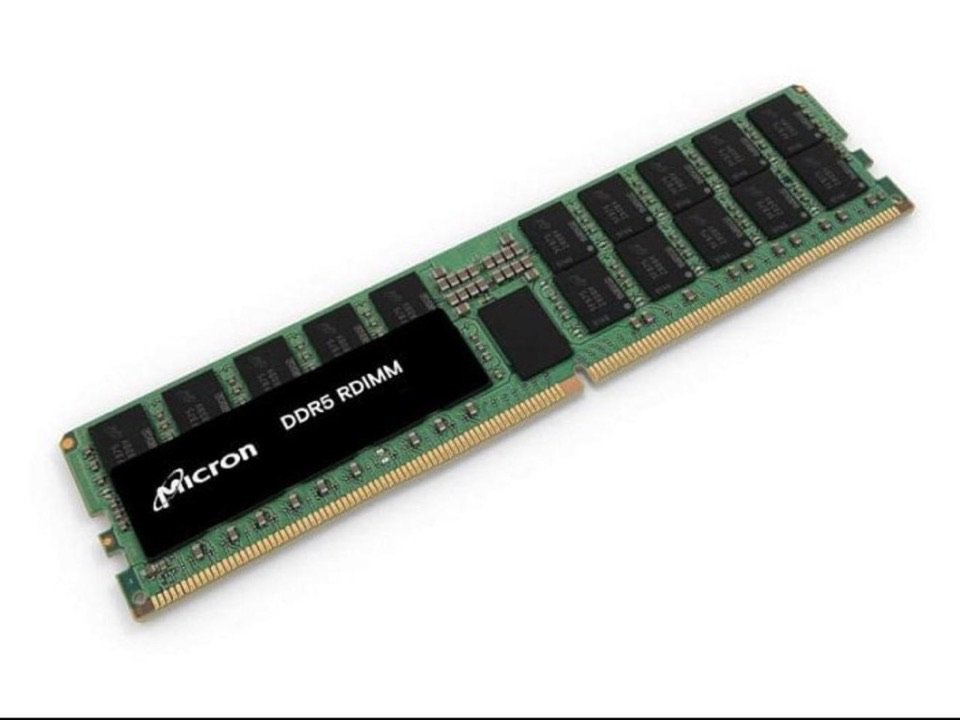
Moduł pamięci Enterprise DDR5 ECC RDIMM

Enterprise DDR5 ECC Memory

Moduły 96 GB · 128 GB · 256 GB

Pamięć DDR5 ECC o dużej pojemności do infrastruktury AI, wirtualizacji, HPC i serwerów enterprise.

Typ
DDR5 ECC Registered DIMM (RDIMM)
Pojemności
96 GB · 128 GB · 256 GB
Korekcja błędów
ECC
Format
Server DIMM
Zastosowanie
Serwery AI, wirtualizacja, HPC, platformy enterprise
Uwagi
Taktowanie i konfiguracja zestawu dobrane do platformy serwerowej w wycenie

To tylko próbka oferty. Pozyskujemy również inne GPU NVIDIA do centrów danych, systemy multi-GPU, serwery enterprise, storage, urządzenia sieciowe i powiązane komponenty — podaj numery katalogowe lub opisz obciążenie.

Briefy konfiguracyjne

Typowe punkty wyjścia do specyfikacji serwera

Te wstępne konfiguracje pokazują poziom szczegółowości potrzebny w briefie. Modele GPU, ich liczba, pamięć i ostateczna specyfikacja systemu są potwierdzane w wycenie, z uwzględnieniem analizy obciążenia i dostępności.

Brief planistycznyWstępna konfiguracjaCo przeanalizować
Serwer inferencyjny1 GPU z 48 GB pamięci; 16 rdzeni CPU; 128 GB RAM; 2 × 1,92 TB NVMe.Rozmiar modelu i precyzja, współbieżność, docelowe opóźnienie i framework serwujący. Potwierdź wymagania sieciowe, obudowy i zasilania lokalizacji.
Serwer treningowy4 GPU z 80 GB pamięci każdy; 64 rdzenie CPU; 512 GB RAM; 2 × 3,84 TB NVMe.Model, zbiór danych, metoda treningowa i rozmiar batcha. Przeanalizuj topologię GPU, pojemność storage, wymagania sieciowe i chłodzenia.
System wielowęzłowy2 węzły, każdy z 4 GPU, 80 GB na GPU, 64 rdzenie CPU i 512 GB RAM. Storage współdzielony i sieć specyfikowane osobno.Skalowalność aplikacji, komunikacja międzywęzłowa i przepustowość storage. Uzgodnij przełączniki, okablowanie, układ rack i zasoby lokalizacji.

Wydajność zależy od aplikacji i stosu oprogramowania. Uwzględnij benchmarki lub kryteria akceptacji, które proponowany system musi spełnić.

Uzgodnij szczegóły przed zamówieniem

Sprzęt i kompatybilność
Dokładne numery katalogowe, ilości, komponenty w zestawie i dopuszczalne zamienniki.
Wymagania lokalizacyjne
Przestrzeń rack, zasilanie, chłodzenie, połączenia sieciowe i dostęp dla dostawy.
Dostawa i gwarancja
Miejsce dostawy, warunki dostawy, przewidywany czas realizacji, gwarancja i procedura zgłoszeń serwisowych.